KVine 🌿
エージェント軌跡を永続ツリーとして扱う、分岐認識 KV キャッシュ。
エージェントは一直線に喋らない — リトライで巻き戻り、並列に分岐し、サブエージェントを生やし、
過去のツール観測が後から書き換わる。 prefix caching(RadixAttention)は「完全一致する接頭辞」しか
再利用できないため、軌跡が木である構造を活かせない。KVine は KV キャッシュそのものを軌跡ツリーとして管理する:
- COW TrajectoryTree —
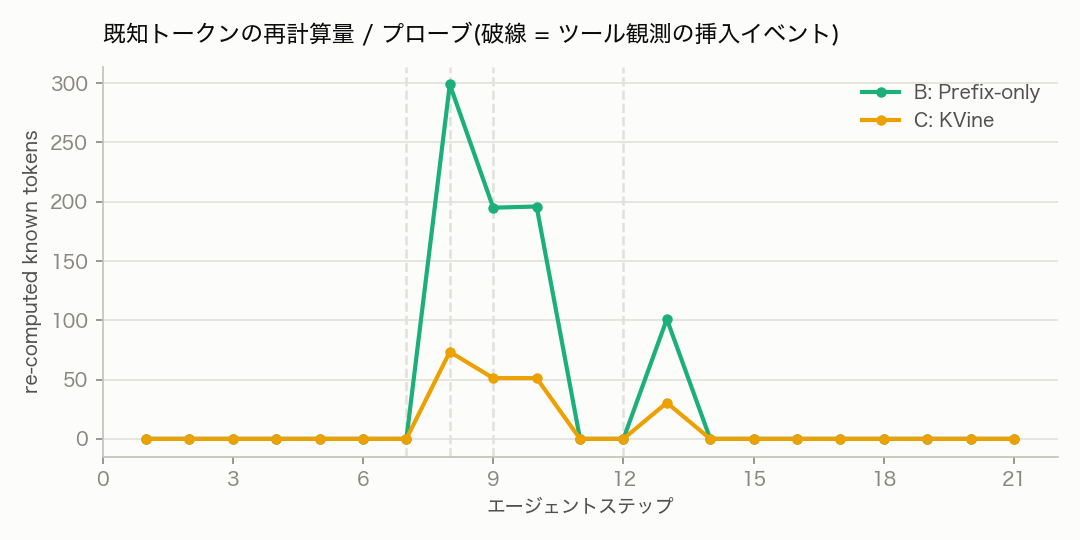
fork()はポインタ共有のみの O(1)、書き込み時だけ実コピー。 - Divergence-bounded 選択的再計算 — 途中挿入を RoPE 位置シフト(厳密)+ 偏差上位15%の再計算で修復。
- 学習レジデントセット方策 — 冷たい枝はディスクへ退避、再訪されそうな枝は RAM 常駐(下のデモ)。
🧠 レジデントセット方策スコアラ(ブラウザ内で動作)
枝の特徴量をスライダで動かすと、学習済み MLP が「近く再訪される確率」を予測する。 高いほど RAM 常駐、低いほどディスク退避。重みはこのページに埋め込まれ、推論は全て JavaScript で行う。
–
heuristic keep-score(LRU+depth): –
学習 MLP は再訪パターンを実行ログから学習しており、random 退避には無い信号を持つ。
学習 MLP は再訪パターンを実行ログから学習しており、random 退避には無い信号を持つ。
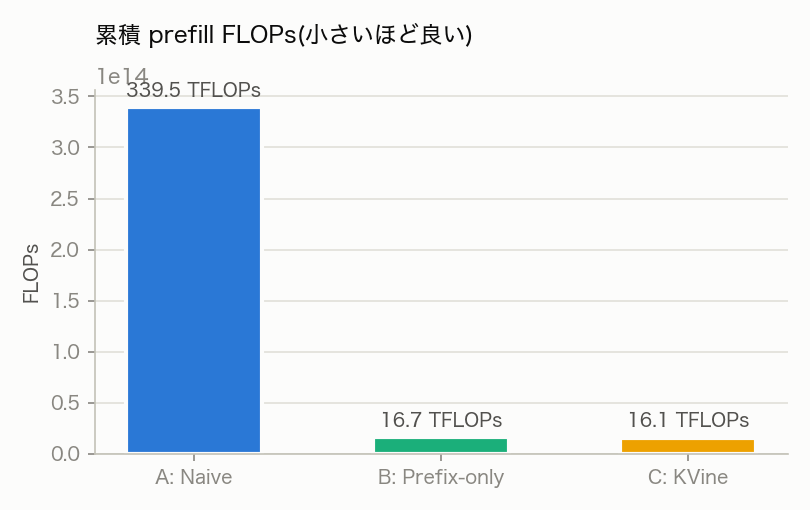
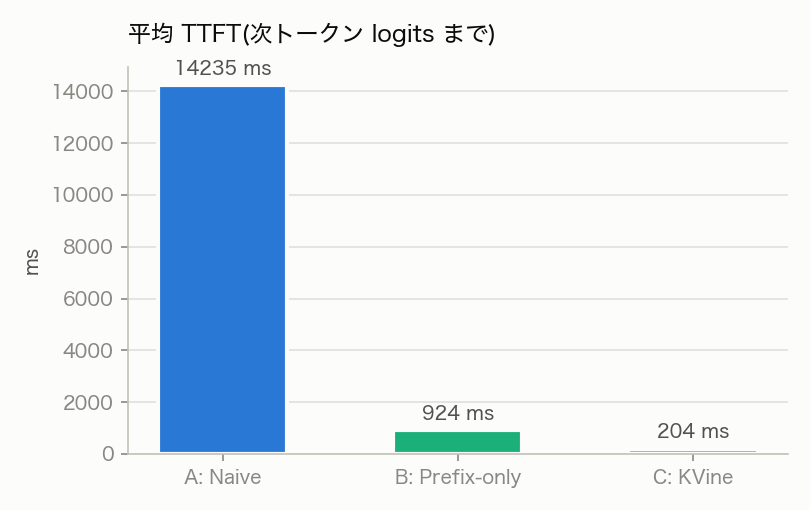
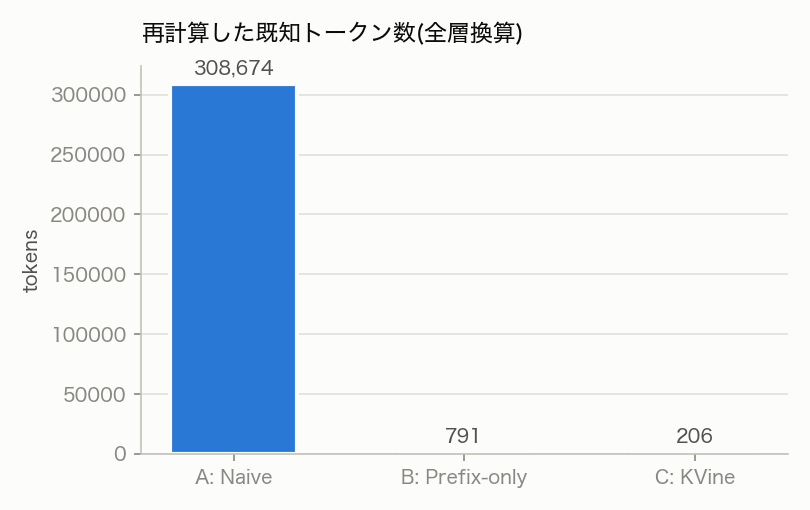
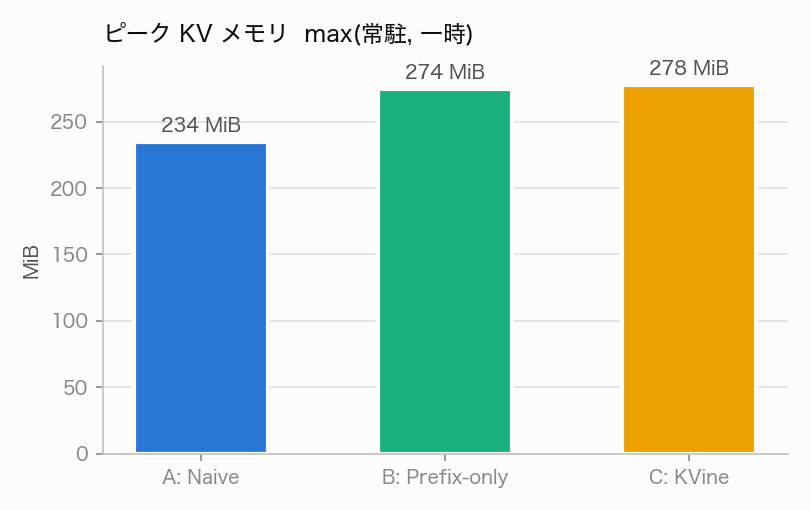
📊 ベンチマーク(root 8k / 20 steps, Qwen2.5-0.5B)
| 指標 | A: Naive | B: Prefix-only | C: KVine |
|---|---|---|---|
| 累積 prefill FLOPs ↓ | 339.5 T | 16.7 T | 16.1 T |
| (A 比) | ×1.000 | ×0.049 | ×0.047 |
| 平均 TTFT ↓ | 14,235 ms | 924 ms | 204 ms |
| 再計算した既知トークン ↓ | 308,674 | 791 | 206 |
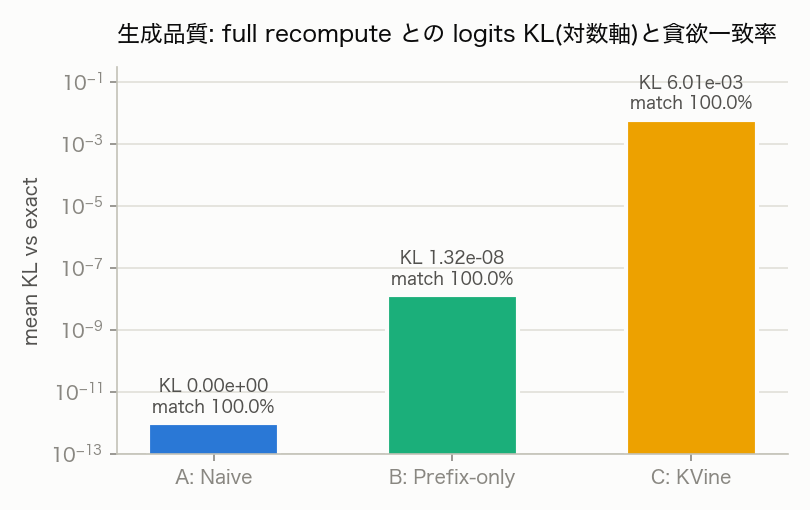
| logits KL vs 厳密 ↓ | 0 | 1.3e-8 | 6.0e-3 |
| 貪欲一致率 ↑ | 100% | 100% | 100% |
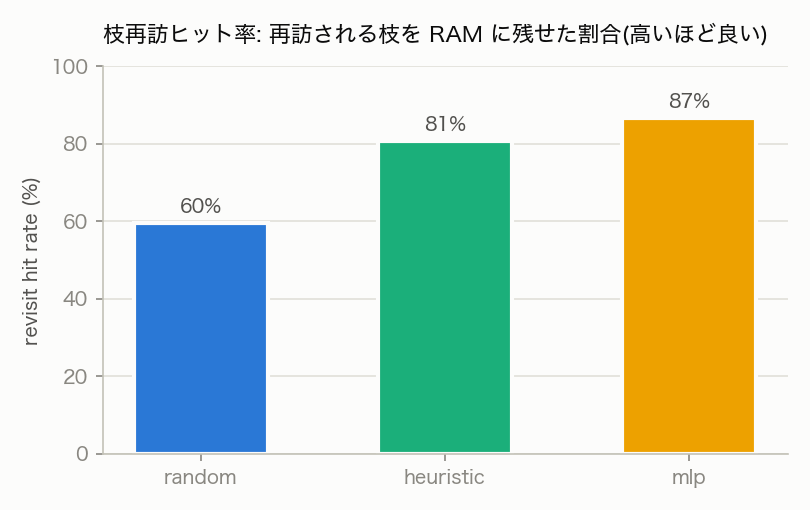
レジデントセット方策の対照(5シード平均・枝再訪ヒット率): random 60%(復元443回) → heuristic 81%(198回) → 学習 MLP 87%(138回)。 良い方策ほどディスク復元が減る。